Просмотр новости
Найдите то, что Вас интересует
 Спутники
 РН
 SpaceX
 Роскосмос
 NASA
СпутникиРНSpaceXРоскосмосNASAНе так давно мы писали обнову нашего публичного синтеза, silero-tts. В прошлый раз мы завезли постановку вопросов.В этот раз доехало аж несколько новых фич: Каких?
Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели60K
Обзор
Да, я знаю, что этот жест на самом деле в Италии особо не используется и значит другое, но мем сам себя не сделает
Не так давно мы писали про обнову нашего публичного синтеза, silero-tts. В прошлый раз мы завезли постановку вопросов.
В этот раз доехало аж несколько новых фич:
Поддержка восклицаний;
Эмфазы (то есть конструкция, когда говорящий выделяет конкретное **слово** в предложении);
Новый релиз нашей библиотеки для простановки ударений (и в обычных словах, и в омографах).
Если просуммировать основные текущие фичи:
Поддержка SSML;
Высокая скорость (до 100x на 4 потоках процессора);
Автоматическая простановка ударений и омографов (новая версия);
Установка через torch.hub, pip и просто локально через торч;
Доступны голоса aidar, baya, kseniya, xenia, eugene;
Поддержка восклицательных предложений;
Поддержка эмфаз: эта булочка **очень** вкусная! ;
Поддержка 4 типов вопросов: специальные (с вопросительным словом), общие (с выделением какого-либо слова), альтернативные ("ты любишь рыбу или мясо?") и вопросы-хвостики ("не так ли?").
И всё это счастье работает на 1 потоке CPU и для этого не нужна видеокарта за несколько миллионов рублей!
Примеры звучанияЭмфазы:
Как работают эмфазы в русском языке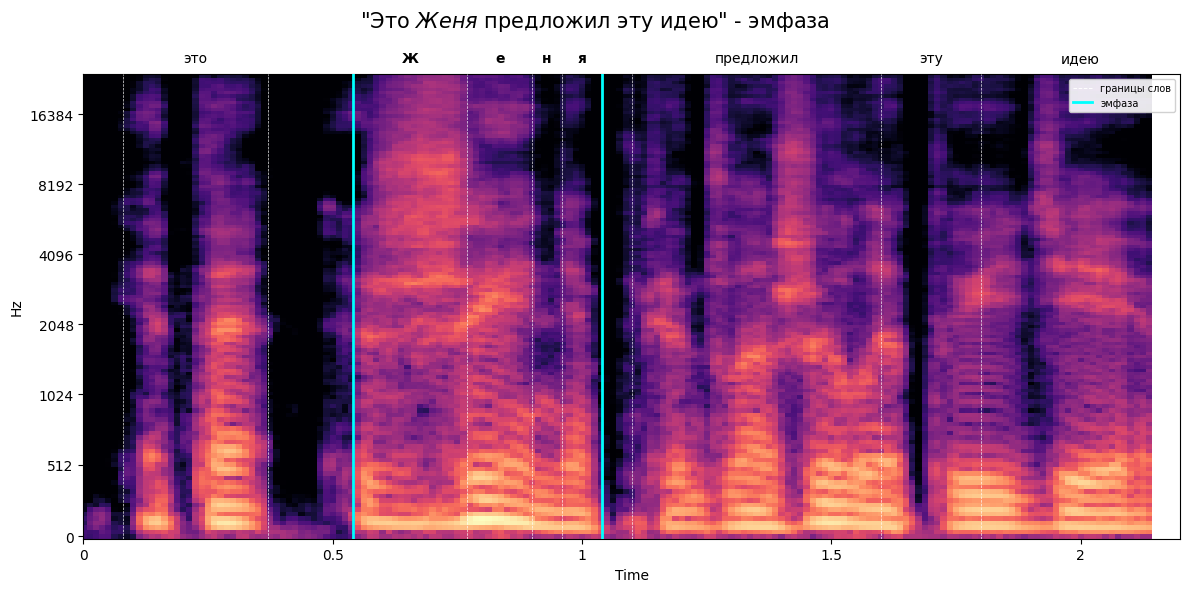
Видим паузу перед эмфазой и значительное удлинение первого согласного в ней.
Коротко говоря, эмфаза - это когда определенное слово во фразе произносится «с нажимом», чтобы слушатель обратил на него внимание. Одна и та же фраза может звучать по-разному: например, можно сказать «Я завтра уезжаю» (а не послезавтра!) или «Я завтра уезжаю» (а не остаюсь на праздник) и таким образом указать собеседнику на то, что важнее.
Кажется, что выделить слово = просто сказать его погромче, но на самом деле в русском языке громкость для эмфазы значит меньше всего. Главное - это темп: эмфаза в первую очередь выражается замедлением, которое начинается на предударных слогах и сильнее всего проявляется на ударном гласном. Другой заметный признак - пауза перед выделяемым словом: чем заметнее говорящий «притормаживает» перед ним, тем сильнее выделение. Изменение интонационного контура и интенсивности (громкости) тоже добавляет выделенности эмфазам, но в меньшей степени.
Итого: эмфатическое выделение в русском языке - явление комплексное и сложное для синтеза, потому что в тексте эмфазы выделяются в лучшем случае курсивом или жирным шрифтом (или вообще никак не выделяются).
Как использовать новую фичу?Просто скачайте новую модель и используйте её как обычно. Для вызова специальных новых фич нужно:
Для эмфаз просто выделить нужное слово двойными звёздочками: эта булочка **очень** вкусная!;
Для восклицаний достаточно использовать восклицательный знак в конце предложения;
Если вопрос общий, то для максимальной выразительности следует выделить интонационный центр одинарными звёздочками. Для альтернативных, специальных или вопросов-хвостиков можно не указывать интонационный центр (если указать, будет получше звучать).
На практике, вот примеры как это использовать:
texts = [
  'Организаторы прислали нам электронные билеты!',
  '**Организаторы** прислали нам электронные билеты.',
  'Организаторы **прислали** нам электронные билеты.',
  'Организаторы прислали нам **электронные** билеты.',
  'Организаторы прислали нам электронные **билеты**.',
  '*Организаторы прислали нам электронные билеты?',
  'Организаторы *прислали* нам электронные билеты?',
  'Организаторы прислали *нам* электронные билеты?',
  'Организаторы прислали нам *электронные* билеты?',
  'Организаторы прислали нам электронные *билеты*?'
]

for i, text in enumerate(texts):
audio = model.apply_tts(text=text, speaker='xenia')Мы уже писали про pip-пакет, pip install silero. Если использовать его, то минимальный код запуска выглядит уже совсем лаконично:
!pip install silero
from silero import silero_tts
model, example_text = silero_tts(language='ru',
                                 speaker='v5_6_ru')
audio = model.apply_tts(text=example_text)
Полный код запуска, например с использованием torch.hub со всеми флагами уже выглядит вот так (подробнее можно потыкать в интерактивном ноутбучке):
import torch

language = 'ru'
model_id = 'v5_6_ru'
device = torch.device('cpu')
model, example_text = torch.hub.load(repo_or_dir='snakers4/silero-models',
                                     model='silero_tts',
                                     language=language,
                                     speaker=model_id)
model.to(device)  # gpu or cpu
sample_rate = 48000
speaker = 'xenia'
put_accent=True
put_yo=True
put_stress_homo=True
put_yo_homo=True

example_text = 'Меня зовут Лева Королев. Я из готов. И я уже готов открыть все ваши замки любой сложности!'

audio = model.apply_tts(text=example_text,
                        speaker=speaker,
                        sample_rate=sample_rate,
                        put_accent=put_accent,
                        put_yo=put_yo,
                        put_stress_homo=put_stress_homo,
                        put_yo_homo=put_yo_homo)

ssml_sample = """
              <speak>
              <p>
                  Когда я просыпаюсь, <prosody rate="x-slow">я говорю довольно медленно</prosody>.
                  Потом я начинаю говорить своим обычным голосом,
                  <prosody pitch="x-high"> а могу говорить тоном выше </prosody>,
                  или <prosody pitch="x-low">наоборот, ниже</prosody>.
                  Потом, если повезет – <prosody rate="fast">я могу говорить и довольно быстро.</prosody>
                  А еще я умею делать паузы любой длины, например, две секунды <break time="2000ms"/>.
                  <p>
                    Также я умею делать паузы между параграфами.
                  </p>
                  <p>
                    <s>И также я умею делать паузы между предложениями</s>
                    <s>Вот например как сейчас</s>
                  </p>
              </p>
              </speak>
              """

audio = model.apply_tts(ssml_text=ssml_sample,
                        speaker=speaker,
                        sample_rate=sample_rate)
Мы, наконец-то, собрали весь набор фич, к которому стремились долгое время. Ещё неплохо было бы добавить управление субъективной громкостью речи, но пока предметно руки не дошли за это взяться.
С эмфазами могут быть небольшие моменты на отдельных краевых случаях, мы исправим их в будущих релизах, но тут всегда идёт перетягивание каната между естественностью эффекта и его силой.
Не секрет, что мы давно готовим большое обновление именно акустического звучания синтеза речи, но тут пока не будем забегать вперёд, есть очевидные и более простые правки таких моделей как v5_cis_base, например.
| # | Наименование новости | Тональность | Информативность | Дата публикации |
|---|---|---|---|---|
| 1 | Теперь silero-tts v5 на русском языке умеет задавать вопросы | 0 | 8.38 | 30-03-2026 |
| 2 | Написал локального ИИ-ассистента для зумов: диаризация, граф знаний и ноль облаков | 0 | 11.78 | 22-07-2026 |
| 3 | Как мы ускоряли диффузионный декодер TTS | 0 | 7.32 | 25-06-2026 |
| 4 | Оповещения о БПЛА через Яндекс Станцию | 0 | 7 | 12-07-2026 |
| 5 | Обзор Open Source моделей для задачи TTS | 0 | 7.62 | 05-02-2026 |
| 6 | Whisper без облака: локальное распознавание чувствительных записей | 0 | 8.1 | 21-09-2026 |
| 7 | Ежедневный Хабр: 9 интересных публикаций каждый день | 0 | 12.21 | 06-08-2026 |
| 8 | Книга: «Эффективный разговорный ИИ. Создаем чат-ботов, которые действительно работают» | 0 | 12.49 | 29-04-2026 |
| 9 | Вышла новая модель: Qwen 3.8 27B | 0 | 16.9 | 14-08-2026 |