Просмотр новости
Найдите то, что Вас интересует
 Спутники
 РН
 SpaceX
 Роскосмос
 NASA
СпутникиРНSpaceXРоскосмосNASAСалют, Хабр! Не так давно мне захотелось сохранить себе подборку статей одного автора: несколько десятков публикаций вместе с комментариями (которые зачастую не менее ценны, чем сами статьи). Конечно, будь статья одна, я, не задумываясь, нажал бы Ctrl+S или Ctrl+P. Но жать их полсотни раз — удовольствие сомнительное. Готовые решения нашлись, но меня ни одно не устроило (о них ниже). Поэтому я, как истинный программист, озадачился написанием собственного инструмента. А как истинный ленивый программист — поручил часть этой задачи Claude Code.Так появился HabrExporter — приложение с графическим интерфейсом и CLI, которое сохраняет статьи, блоги авторов и закладки Хабра в PDF, EPUB, Markdown и ещё нескольких форматах. PDF при этом выглядит точь‑в‑точь как на сайте, вместе с деревом комментариев, а данные программа берёт не парсингом HTML, а из внутреннего API Хабра. О том, как это устроено, что умеет программа, я и расскажу. Save as...
Салют, Хабр!
Не так давно мне захотелось сохранить себе подборку статей одного автора: несколько десятков публикаций вместе с комментариями (которые зачастую не менее ценны, чем сами статьи). Конечно, будь статья одна, я, не задумываясь, нажал бы Ctrl+S или Ctrl+P. Но жать их полсотни раз — удовольствие сомнительное. Готовые решения нашлись, но меня ни одно не устроило (о них ниже). Поэтому я, как истинный программист, озадачился написанием собственного инструмента. А как истинный ленивый программист — поручил часть этой задачи Claude Code.
Так появился HabrExporter — приложение с графическим интерфейсом и CLI, которое сохраняет статьи, блоги авторов и закладки Хабра в PDF, EPUB, Markdown и ещё нескольких форматах. PDF при этом выглядит точь‑в‑точь как на сайте, вместе с деревом комментариев, а данные программа берёт не парсингом HTML, а из внутреннего API Хабра.
О том, как это устроено, что умеет программа, я и расскажу.
Раз уж мы говорим про сохранение статей с Хабра, в том числе массовое сохранение, на всякий случай напомню, что есть такая статья 1273 ГК РФ («Свободное воспроизведение произведения в личных целях»). Она разрешает гражданам без согласия автора или правообладателя и без выплаты вознаграждения воспроизводить (то есть копировать) правомерно обнародованные произведения. Статьи на Хабре находятся в открытом доступе, то есть обнародованы правомерно и подпадают под эту статью.
При скачивании в больших объёмах начинает действовать статья 1335.1 ГК, которая разрешает извлекать материалы из базы данных без согласия правообладателя в личных, научных и образовательных целях в объеме, оправданном этими целями (то есть при необходимости допускается копирование даже существенной части или всей базы целиком). Лишь в иных (коммерческих) целях закон ограничивает извлечение объёмом, составляющим несущественную часть базы данных.
Немного про использование ИИ...а вернее, LLM. Сразу скажу честно: в разработке проекта я использовал Claude Code. Почему? Причин несколько:
Изначально я планировал набросать небольшую одноразовую GUI‑программку для личного использования. Однако количество фич всё росло, код ширился и множился и дошёл до 10 тысяч строк. Писать такой объём вручную в одиночку мне было бы крайне нелегко (да и лень:‑) ).
Раньше я почти не работал с Qt. Несмотря на то, что я понимаю базовые принципы GUI, погружение и изучение документации заняло бы больше времени, чем непосредственно написание кода.
Ну и, конечно, ИИ здорово экономит время, а когда его почти нет, это особенно ценно. (В данном случае на проект у меня ушло всего 2–3 неполных дня.)
Это всё, конечно, не значит, что разработка должна сводиться к штамповке промптов в духе «no mistakes please». Claude охотно пишет код, но далеко не всегда тот, который нужен. Так что думать, проверять и решать, что вообще строим, приходится самому. Однако в тех областях, где я разбираюсь хуже, LLM существенно облегчает жизнь.
Ну, а чтобы не было соблазна принимать код на веру, проект с самого начала обвешан тестами: их тут около 4 тысяч строк, а CI на каждый коммит прогоняет линтер и набор тестов под все ОС.
Почему именно HabrExporterРазумеется, задача сохранения публикаций Хабра возникла не сегодня. Вот, например, некоторые проекты:
Habr Article Downloader — браузерное расширение (статья на Хабре от разработчика).
Отличный инструмент для быстрого сохранения из браузера. Много полезных фич, таких как пакетная загрузка, слежение за изменениями, фильтры. Но есть и некоторые минусы: экспорт только в Markdown, работает как расширение (не всегда удобно), и есть ограничения по комментариям.
habrArticleSrcDownloader — Python‑скрипт (статья на Хабре от разработчика).
До сих пор поддерживается: сохраняет статьи, комментарии и картинки. Из минусов — только форматы Markdown и HTML, без оформления сайта.
Есть и давно заброшенные проекты:
Ни один из этих проектов мне не подошёл, так что пришлось взяться за дело самому.
Что это за зверьHabrExporter написан полностью на Python и представляет собой десктопное приложение на PyQt6. Для тех, кому привычнее командная строка, есть и CLI‑версия на том же ядре: в ней доступны все те же самые функции экспорта. Далее я буду описывать функционал именно GUI‑версии.
РежимыОдиночная загрузкаГлавный экран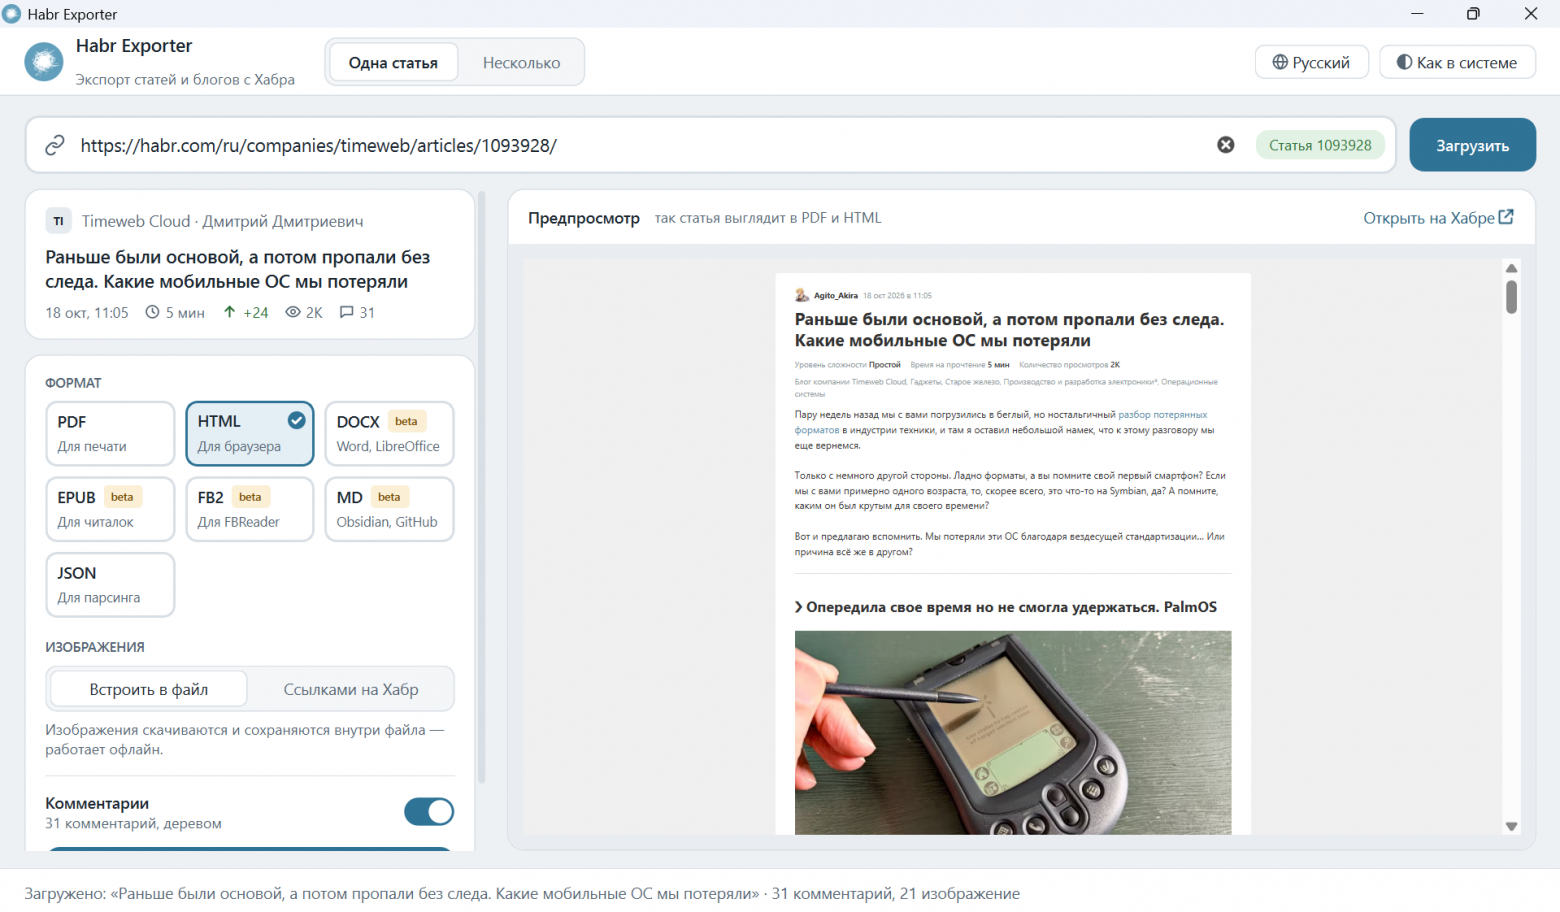
Главный экран
В этом режиме можно скачать одну публикацию. Поддерживаются статьи и новости любых лет, посты — нет.
Здесь всё достаточно интуитивно. Вставляете ссылку, нажимаете «Загрузить», и открывается предпросмотр: так публикация будет выглядеть в PDF или HTML. В боковой панели можно:
выбрать формат: PDF, HTML, DOCX, EPUB, FB2, Markdown или JSON;
выбрать способ работы с изображениями: встроить в файл (для офлайна) или оставить ссылками на habrastorage.org;
включить или выключить сохранение комментариев.
Остаётся нажать «Сохранить» (Ctrl+S) и выбрать, куда положить файл.
Пакетная загрузкаЭкран пакетной загрузки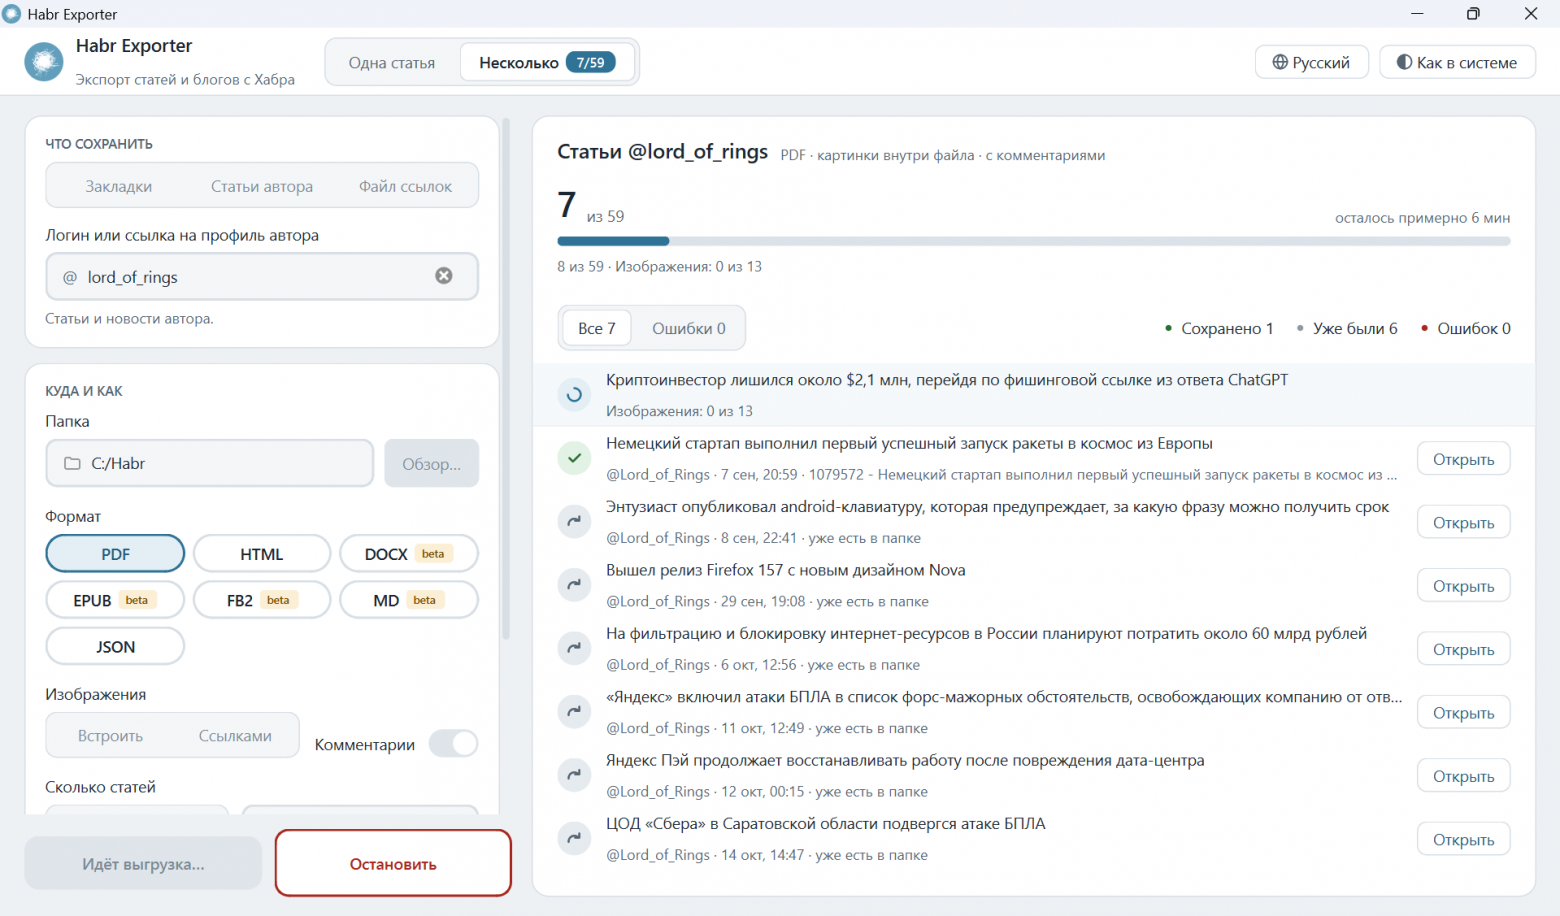
Экран пакетной загрузки
Этот режим предназначен для массового скачивания статей. Здесь можно скачать:
закладки любого пользователя (если они доступны публично);
статьи любого автора, включая новости;
список ссылок из текстового файла, по одной на строку.
Удалённые статьи, черновики и статьи, ограниченные по юридическим причинам (HTTP 451), скачать, разумеется, нельзя.
Помимо настроек одиночного режима, можно выбрать, сколько последних статей скачивать, и задать паузу между запросами.
Если статья в выбранном формате уже лежит в папке, она пропускается, так что повторный запуск докачивает только новое: получается нечто вроде простого инкрементального бэкапа. После завершения скачивания, вне зависимости от выбранного формата, будет сформирован index.html с навигацией по статьям.
Для тех, кому привычнее терминал или кто хочет автоматизировать загрузку, есть консольная версия. Она использует то же ядро, что и GUI, и умеет всё то же самое, что связано с экспортом.
Так, например, скачивается одна статья:
habr-exporter-cli https://habr.com/ru/articles/123456/ -f html -i embed -o ./saved/Здесь -f задаёт формат (pdf, html, docx, epub, fb2, md, json), -i — режим изображений (embed встраивает в файл, link оставляет ссылки), -o — файл или папку. Вместо ссылки можно передать просто номер статьи.
Для пакетной выгрузки вместо ссылки укажите источник:
habr-exporter-cli --bookmarks boomburum -f pdf -o ./bookmarks/
habr-exporter-cli --author boomburum -f html --delay 2 -o ./boomburum/
habr-exporter-cli --from-file links.txt -f docx -o ./saved/
Дополнительно есть --limit N (сохранить не больше N последних статей), --delay SEC (пауза между запросами), --no-comments и -q для отключения вывода.
CLI старается быть вежливым соседом в скриптах: в stdout пишет только путь к готовому файлу, всё остальное — в stderr, а по коду возврата видно, чем всё кончилось (0 — успех, 2 — часть статей не сохранилась, 1 — всё плохо). А JSON можно сразу скормить jq.
Доступно 7 форматов: 3 стабильных (PDF, HTML, JSON) и 4 в бете (DOCX, EPUB, FB2, Markdown). В бета‑форматах возможны проблемы с вёрсткой и могут наблюдаться проблемы с открытием, однако в остальном они полностью рабочие.
PDF и HTML: оформление максимально приближено к Хабру. PDF удобен для чтения и печати, HTML — точная копия страницы.
DOCX: стили Word, близкие к Хабру, файл можно редактировать. Дерево комментариев пока проработано слабо.
EPUB и FB2: для электронных книг и читалок. Оформление частично определяет сама читалка, комментарии читать неудобно.
Markdown: для заметок, вики и проч.. Файл начинается с YAML‑заголовка, в котором хранятся метаданные.
JSON: полезен для парсинга и автоматизаций. Также включает метаданные, HTML‑текст публикации и комментарии.
Структура статьи (заголовки, списки, таблицы, код, спойлеры) сохраняется во всех форматах, но детали оформления могут различаться. Изображения можно встраивать в файл везде, кроме JSON.
Так, например, выглядит PDF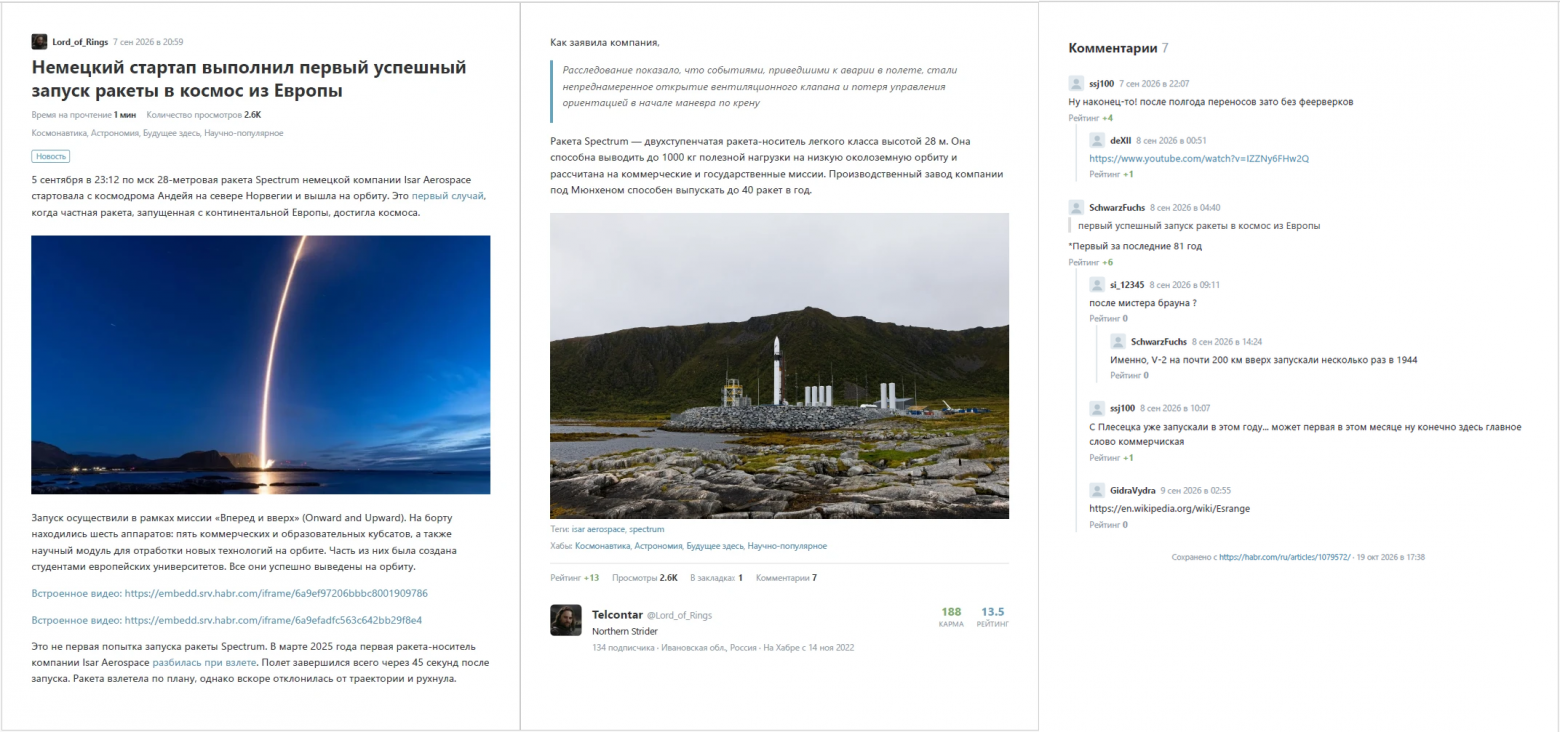
Так, например, выглядит PDF
Самое интересное под капотом — откуда программа вообще берёт статьи. Очевидный путь — парсить HTML‑страницу, так делают все инструменты для Хабра, что я видел. Но парсить вёрстку — занятие неблагодарное: стоит Хабру переставить пару div‑ов, и всё ломается. Поэтому я решил пойти немного другим путём.
Официально публичного и открытого API у Хабра нет. Неофициально — открываем DevTools, вкладку Network, обновляем любую страницу и видим:
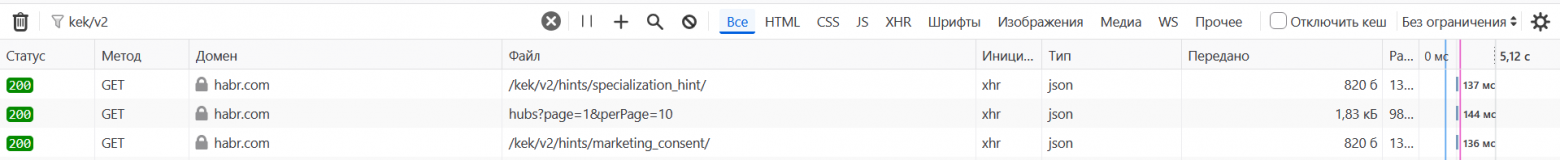
Да, внутренний API Хабра живёт по адресу /kek/v2/. Кто-то в команде Хабра явно с чувством юмора)
Все эти запросы открыты, и большинство из них не требуют авторизации. Дальше остаётся только выяснить нужные эндпоинты. Сделать это нетрудно, и в итоге получаем такую табличку:
Запрос | Что возвращает |
| Текст и метаданные публикации |
| Комментарии |
| Информация об авторе |
| О компании |
| Закладки |
| Статьи |
| Новости |
В итоге https://habr.com/kek/v2/articles/1095320/ вернёт что‑то вроде этого:
{
  "id": "1095320",
  "timePublished": "2026-10-21T09:02:17+00:00",
  "isCorporative": true,
  "lang": "ru",
  "titleHtml": "Изучаем многозадачность FreeRTOS на примере создания логгера для STM32",
  "leadData": {
    "textHtml": "<p>Логирование является важной составной частью отладки...</p>",
    "imageUrl": "https://habrastorage.org/extt/.../cover.png",
    "buttonTextHtml": "Читать далее",
    "image": { "url": "https://habrastorage.org/extt/.../cover.png", "fit": "cover", "positionY": 0, "positionX": 0 }
  },
  "editorVersion": "2.0",
  "postType": "article",
  "postLabels": [],
  "author": {
    "id": "3275257",
    "alias": "artyomsoft",
    "fullname": null,
    "avatarUrl": "//habrastorage.org/getpro/habr/avatars/.../avatar.jpg",
    "speciality": null,
    "deleted": false,
    "isSeo": false,
    "scoreStats": { "score": 268, "votesCount": 292 },
    "rating": 145.1,
    "relatedData": {
      "vote": { "value": 1 },
      "canVote": true,
      "votePlus": { "canVote": true, "isKarmaEnough": true, "isChargeEnough": true, "isPublicationLimitEnough": true },
      "voteMinus": { "canVote": true, "isKarmaEnough": true, "isChargeEnough": true, "isPublicationLimitEnough": true },
      "isSubscribed": false
    },
    "contacts": [],
    "authorContacts": [],
    "paymentDetails": { "paymentYandexMoney": null, "paymentPayPalMe": null, "paymentWebmoney": null },
    "donationsMethod": null,
    "isInBlacklist": false,
    "careerProfile": null,
    "isShowScores": true,
    "reach": "32K+"
  },
  "statistics": {
    "commentsCount": 0,
    "favoritesCount": 18,
    "readingCount": 1461,
    "score": 24,
    "votesCount": 13,
    "votesCountPlus": 13,
    "votesCountMinus": 0,
    "reach": 6725,
    "readers": 1134
  },
  "hubs": [
    {
      "id": "19791",
      "alias": "ruvds",
      "type": "corporative",
      "title": "Блог компании RUVDS.com",
      "titleHtml": "Блог компании RUVDS.com",
      "isProfiled": false,
      "relatedData": { "isSubscribed": false }
    }
  ],
  "flows": [
    { "id": "1", "alias": "develop", "title": "Разработка", "titleHtml": "Разработка" }
  ],
  "relatedData": {
    "vote": { "value": null, "voteTimeExpired": "2026-11-20T09:02:17+00:00" },
    "unreadCommentsCount": 0,
    "bookmarked": false,
    "canComment": true,
    "canEdit": false,
    "canViewVotes": false,
    "votePlus": { "canVote": true, "isChargeEnough": true, "isKarmaEnough": true, "isVotingOver": false, "isPublicationLimitEnough": true },
    "voteMinus": { "canVote": true, "isChargeEnough": true, "isKarmaEnough": true, "isVotingOver": false, "isPublicationLimitEnough": true },
    "draftReason": null,
    "lockReason": null,
    "canModerateComments": false,
    "trackerSubscribed": false,
    "emailSubscribed": false
  },
  "textHtml": "<div xmlns=\"http://www.w3.org/1999/xhtml\"><p>Логирование является...</p><h2>Подключаем FreeRTOS</h2><p>...</p><pre><code class=\"cpp\">void Logger_Init(void) { ... }</code></pre></div>",
  "tags": [
    { "titleHtml": "stm32" },
    { "titleHtml": "freertos" }
  ],
  "metadata": {
    "stylesUrls": [],
    "scriptUrls": [],
    "shareImageUrl": "https://habr.com/share/publication/1095320/.../",
    "shareImageWidth": 1200,
    "shareImageHeight": 630,
    "vkShareImageUrl": "https://habr.com/share/publication/1095320/.../?format=vk",
    "schemaJsonLd": "{\"@context\":\"http://schema.org\",\"@type\":\"Article\",...}",
    "metaDescription": "Логирование является важной составной частью...",
    "mainImageUrl": null,
    "amp": false,
    "customTrackerLinks": []
  },
  "polls": [],
  "commentsEnabled": { "status": true, "reason": null },
  "rulesRemindEnabled": false,
  "votesEnabled": true,
  "status": "published",
  "plannedPublishTime": null,
  "isSeo": false,
  "checked": null,
  "hasPinnedComments": false,
  "format": "tutorial",
  "banner": {
    "url": "https://ruvds.com/ru/baremetal_start/?utm_source=habr&...",
    "desktopImageUrl": "//habrastorage.org/getpro/habr/company/post_desktop/.../banner.png",
    "mobileImageUrl": "//habrastorage.org/getpro/habr/company/post_mobile/.../banner.png",
    "uuid": "01a06277-85d6-7238-b15f-2c93593bec27"
  },
  "multiwidget": null,
  "multiwidgetUuid": null,
  "readingTime": 8,
  "complexity": "medium",
  "isEditorial": false,
  "flowNew": { "id": "44", "title": "DIY", "alias": "diy" },
  "linkedPostTranslation": null,
  "hasRegionalRestrictions": false,
  "canExplanation": true,
  "allowedFeatures": { "isTestTargetAllow": false }
}
Естественно, это существенно облегчает задачу. Заголовок, автор, хабы, текст, комментарии — всё уже разложено по полочкам. Никакого выковыривания данных из вёрстки.
Как устроеноЕсли проследить путь одной статьи от ссылки до файла, получится примерно так:
Скрытый текст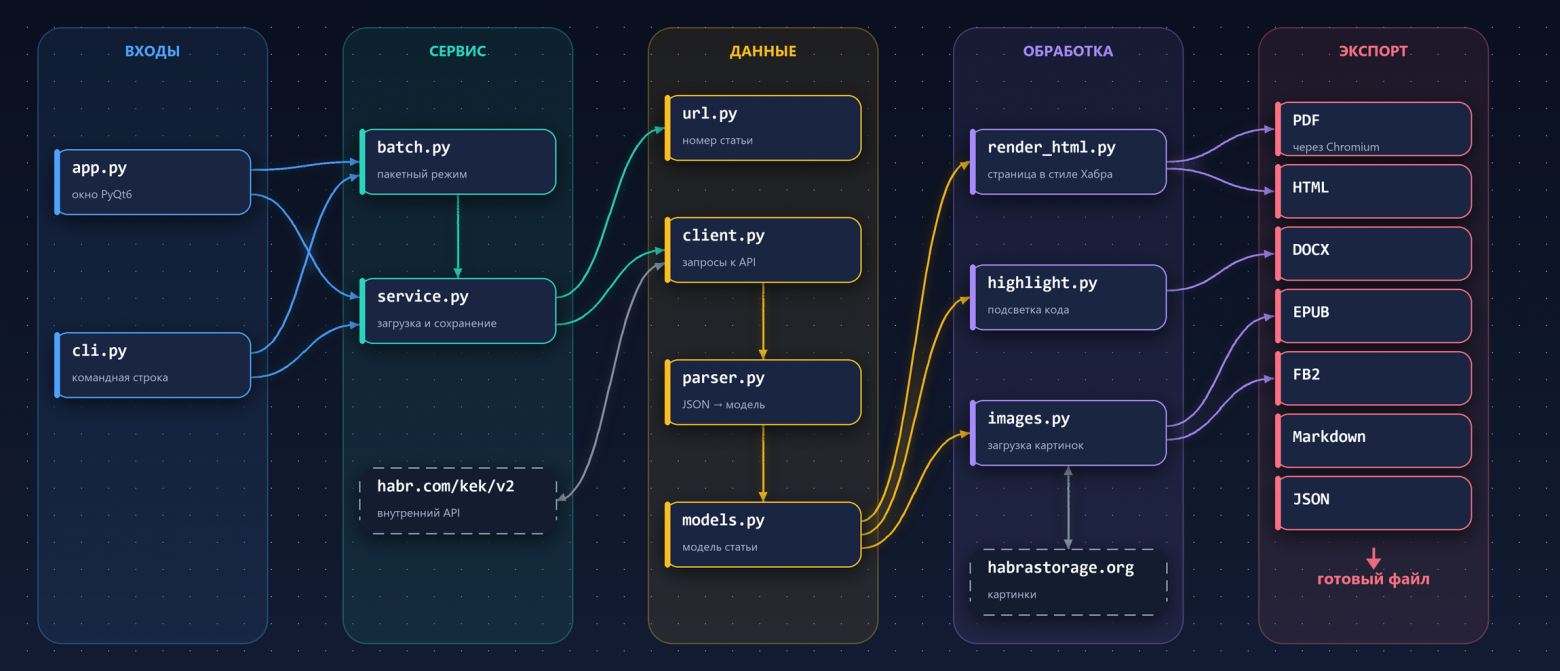
Всё начинается с окна на PyQt6 (app.py) или с консоли (cli.py). Это просто две двери в одно и то же ядро, поэтому всё, что умеет GUI в плане экспорта, умеет и CLI.
Дальше url.py выковыривает из ссылки номер статьи, client.py сходит с ним в API, а parser.py превратит ответ в нормальную модель статьи (models.py): почистит HTML и соберёт комментарии в дерево. Модель ничего не знает ни про сеть, ни про Qt — это сильно упростило тестирование: парсер проверяется на сохранённых ответах API, а не на живом Хабре.
Командует всем этим service.py: загрузить статью, скачать картинки, сохранить файл. Для пакетного режима поверх него есть batch.py: он собирает список статей, пропускает уже скачанные и в конце рисует index.html.
Картинками занимается images.py: качает их параллельно, складывает в кэш и, если формат не переваривает WebP или SVG‑формулы, перегоняет их в PNG. Код раскрашивает highlight.py.
Ну а в конце у каждого формата свой экспортёр. Почти все они устроены скучно и одинаково, кроме PDF: его печатает встроенный Chromium. О нём отдельно.
Зачем здесь Chromium?Если заглянуть на страницу релизов, может слегка перехватить дыхание: 150 МБ за программу, которая сохраняет статьи. Виноват встроенный Chromium (Qt WebEngine). Но без него не получилось бы главного — PDF и предпросмотра, которые выглядят точь-в-точь как сайт.
Логика простая: Хабр — это HTML и CSS, и лучше всего его рисует браузер. Так что программа собирает одну страницу в стиле Хабра (render_html.py и habr.css) и использует её трижды:
HTML‑файл: страница сохраняется как есть, со стилями внутри, без JavaScript и внешних зависимостей;
предпросмотр в окне программы: вы видите, как статья будет выглядеть, ещё до сохранения;
PDF — ту же страницу Chromium печатает в A4 (printToPdf). Получается ровно то, что вы видите в браузере, только порезанное на страницы.
Альтернатива — собирать PDF отдельной библиотекой и заново, вручную, воспроизводить всю вёрстку Хабра. Как говорится, спасибо, но нет.
Расплата — вес релиза и капризы WebEngine. Главный каприз: работать с ним можно только из главного (GUI) потока, а пакетная выгрузка крутится в фоне. В итоге фоновый поток только готовит HTML, отдаёт его главному и вежливо ждёт, пока тот напечатает PDF. Для консоли пришлось сделать отдельную синхронную обёртку со своим циклом событий.
Немного про ограниченияКак я уже говорил, у программы есть некоторые ограничения:
API. API у Хабра внутренний и недокументированный. Сейчас он открыт и работает без авторизации, но если Хабр решит его поменять — придётся чинить.
Скачать можно только то, что видно без входа. Авторизация не поддерживается, поэтому в пакетном режиме доступны только публичные закладки. Черновики, удалённые статьи и статьи, закрытые по юридическим причинам (HTTP 451), сохранить нельзя.
Посты не поддерживаются. Только статьи и новости.
Бета‑форматы. DOCX, EPUB, FB2 и Markdown пока в бете, так что вёрстка там может местами чудить.
Видео и встроенные плееры для офлайна не сохраняются: вместо них остаётся ссылка.
И главное: статьи принадлежат их авторам. Сохраняйте для себя и соблюдайте правила Хабра. По умолчанию программа делает секундную паузу между запросами, чтобы не создавать нагрузку на сайт, — пожалуйста, не отключайте её на больших выгрузках.
На этом всё! Надеюсь, статья оказалась вам хоть чуточку интересной и полезной. Весь исходный код проекта доступен на GitHub:
GitHub - GVCoder09/HabrExporter: Desktop app to export Habr articles with comments and images to PDF, HTML, DOCX, EPUB, FB2, Markdown and JSON. GUI, batch and CLI modes.
Там же можно скачать бинарники под Windows 10+ и Linux (проверено на Ubuntu 26.04). Буду рад увидеть ваши замечания, предложения, Issues и PR.
Подписывайтесь на мой телеграм‑кан... Так, стоп... У меня же нет телеграм‑канала... 🤔 Ну тогда можете просто поставить плюсик статье ;-)
Только зарегистрированные пользователи могут участвовать в опросе. Войдите, пожалуйста.
14.29%Статья — нейрослоп!1
0%Программа — нейрослоп!0
14.29%Автор изобрел велосипед1
14.29%Очередная статья в духе «посмотрите, что я навайбкодил»1
57.14%Полезная вещь, пригодится4
Проголосовали 7 пользователей. Воздержался 1 пользователь.
Только зарегистрированные пользователи могут участвовать в опросе. Войдите, пожалуйста.
28.57%Положительно2
71.43%Нейтрально5
0%Отрицательно0
Проголосовали 7 пользователей. Воздержался 1 пользователь.
| # | Наименование новости | Тональность | Информативность | Дата публикации |
|---|---|---|---|---|
| 1 | Я выкачал 1 000 лучших статей Хабра за год, чтобы понять, почему меня так мало плюсуют | 0 | 11.04 | 20-10-2026 |
| 2 | Ежедневный Хабр: 9 интересных публикаций каждый день | 0 | 12.21 | 06-08-2026 |
| 3 | Блог на автопилоте: markdown в статику, выход статьи по дате и пинг в IndexNow только для новых страниц | 0 | 10.98 | 08-10-2026 |
| 4 | Мне надоело писать один и тот же код. Поэтому я сделал Featuregen | 3 | 6 | 09-07-2026 |
| 5 | AGR.Checker: что нового в плагине для проверки ЦИМ перед сдачей в АГР | 0 | 4.96 | 28-09-2026 |
| 6 | CraftHub: я устал редактировать JSON руками — а сообщество помогло превратить это в удобный инструмент | 0 | 10.31 | 03-07-2026 |
| 7 | Анализатор спектра SDR на базе HackRF One | 0 | 7.92 | 23-10-2026 |
| 8 | Как я воевал с Яндексом и решил проблему «мертвых душ» на диске | 0 | 6.66 | 05-08-2026 |
| 9 | Как я искал себе читалку и придумал новый формат электронных книг для изучающих язык | 0 | 5.5 | 08-07-2026 |
| 10 | Оптимизируем отпуск как инженеры: искусство продавать выходные | 0 | 10.62 | 20-10-2026 |